
CQRS
CQRS, also Command Query Responsibility Segregation, ist ein Entwurfsmuster in der Softwarearchitektur, das die Trennung der Lesevorgänge (Query) von den Schreibvorgängen (Command) in einem IT-System vorsieht. Das zentrale Ziel seiner Implementierung ist die Verbesserung der Performance durch die dedizierte, unabhängige Bearbeitung von Abfragen und Operationen, wodurch sich jeder dieser Systemteile unabhängig optimieren lässt. Zudem fördert das CQRS-Muster die Trennung der Verantwortlichkeiten sowie die Erstellung modularer, einfacher zu wartender und zu testender Anwendungen. Sein Verständnis und die korrekte Anwendung können entscheidend für die Wirksamkeit und Effizienz einer IT-Lösung sein.
Sehen Sie ausgewählte Projekte für unsere Kunden
Migration von Mobile zu Web ohne Verlust von Nutzern und Geschäftslogik
Kunde: SkinApe
Branche: Gaming & GameTech
Geschichte und Entwicklung von CQRS
Command Query Responsibility Segregation ist ein Architekturmuster, das in den letzten beiden Jahrzehnten an Beliebtheit gewonnen hat, dessen Wurzeln jedoch noch weiter zurückreichen. Die Einführung von CQRS in den Mainstream der Softwarearchitektur lässt sich einigen zentralen Persönlichkeiten und Ereignissen zuschreiben.
Anfänge und Kontext:
In den 90er Jahren und Anfang der 2000er Jahre begann sich die Softwareentwicklung zunehmend auf Skalierbarkeit, Performance und Systemkomplexität zu konzentrieren. Systeme, die auf einem klassischen Ansatz basierten und Schreib- und Lesevorgänge einheitlich behandelten, stießen angesichts der wachsenden Nutzerzahlen und Geschäftsanforderungen an ihre Grenzen. Diese Herausforderung inspirierte die Entwicklung verschiedener Architekturmuster, darunter CQRS.
Formalisierung von CQRS:
Obwohl Elemente von CQRS bereits früher in verschiedenen Formen vorhanden waren, erfolgte die formale Einführung des Musters in die breitere Diskussion um das Jahr 2009. Damals begann Greg Young, einer der Pioniere von CQRS, dieses Muster zu popularisieren, insbesondere durch seine Vorträge und Artikel. Greg Young identifizierte, dass die Trennung der Verantwortlichkeiten für Schreib- und Lesevorgänge die Performance und Skalierbarkeit von Systemen erheblich verbessern kann.
Entwicklung und Adaption:
Mit der Zeit wurde CQRS im Entwicklerumfeld immer verbreiteter. Seine Anwendung wurde durch die Entwicklung weiterer Muster und Technologien unterstützt, etwa Event Sourcing, das sich natürlich mit CQRS verbindet und eine noch fortgeschrittenere Verwaltung des Zustands und der Änderungshistorie in Systemen ermöglicht. Event Sourcing, das jedes den Systemzustand ändernde Ereignis speichert, ergänzt das Konzept von CQRS ideal und ermöglicht einen flexibleren und skalierbareren Ansatz zur Datenverwaltung.
Anwendungsbeispiele:
Als das CQRS-Muster an Beliebtheit gewann, begannen viele Organisationen, es in ihren Projekten einzuführen, insbesondere in Fällen, in denen hohe Skalierbarkeit und Systemkomplexität gefordert waren. Unternehmen wie Microsoft, Amazon oder Netflix begannen, ihre Erfahrungen mit CQRS zu dokumentieren, was zur weiteren Verbreitung und zum besseren Verständnis dieses Musters im professionellen Umfeld beitrug.
Entwicklung und zeitgenössische Trends:
Heute wird CQRS weithin als einer der zentralen Ansätze in der Softwarearchitektur anerkannt, insbesondere im Kontext verteilter Systeme und Microservices. Moderne CQRS-Implementierungen kombinieren das Muster häufig mit modernen Cloud-Technologien und Datenverwaltungsplattformen, was eine effektive Verwaltung von Komplexität und Performance ermöglicht. Das Muster entwickelt sich weiter und passt sich an veränderte Anforderungen und Technologien an, etwa Kubernetes oder verschiedene NoSQL-Datenbanken.
Command und Query: Zwei Säulen von CQRS
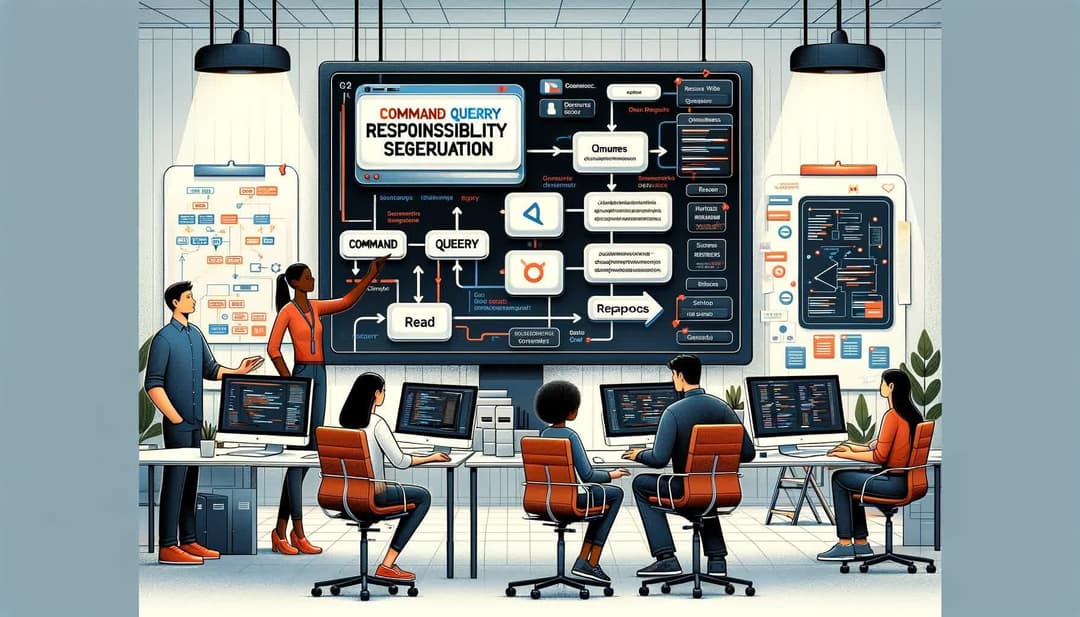
Command und Query, zwei grundlegende Konzepte, die aus der Struktur von CQRS hervorgehen, teilen die Anwendung in zwei unabhängige Teile: einen zum Schreiben von Daten (Command) und einen zum Lesen (Query). Command ist für alle Operationen zuständig, die den Zustand der Anwendung ändern, also sämtliche Schreibaktionen – Hinzufügen, Löschen oder Bearbeiten von Daten. Query dagegen ist der Bereich, der dem Lesen der Daten gewidmet ist. Eine solche Segregation erlaubt die Optimierung jedes Teils im Hinblick auf seine spezifischen Anforderungen. Das trägt dazu bei, Performance und Skalierbarkeit der Anwendung zu steigern, und ermöglicht es, sich auf einzelne Aspekte zu konzentrieren, ohne das gesamte System zu beeinflussen.
Command and Query Responsibility Segregation verstehen: Beispiele
Command and Query Responsibility Segregation wird außerordentlich leicht verständlich, wenn wir einige praktische Beispiele heranziehen. Nehmen wir an, wir haben einen Online-Shop. Commands sind in diesem Kontext Aktionen wie das Hinzufügen eines Produkts zum Warenkorb oder das Aufgeben einer Bestellung. Queries hingegen sind Aktionen wie das Prüfen des Lagerbestands eines bestimmten Produkts oder das Anzeigen der Bestellhistorie eines Nutzers. Jede dieser Aktionen ist entweder ein Command oder ein Query – das ist der Kern von CQRS. Auf diesem Konzept aufbauende Systeme sind einfacher zu warten und zu erweitern, weil sie die Bearbeitung von Operationen, die den Systemzustand ändern (Commands), von den Operationen trennen, die Informationen lesen (Queries).
Wann lohnt sich der Einsatz von CQRS? Einsatzszenarien
CQRS findet Anwendung in Systemen mit spezifischen Anforderungen an das Lesen und Schreiben von Daten. Wenn Schreibvorgänge selten sind, aber eine hohe geschäftliche Komplexität aufweisen, und gleichzeitig Lesevorgänge schnell und performant sein müssen, kann CQRS die Performance des Systems erheblich verbessern. Das ist besonders in E-Commerce-Anwendungen nützlich, in denen die Anzahl der Abfragen zur Produktverfügbarkeit um ein Vielfaches höher ist als die Anzahl der Änderungen am Lagerbestand. Ähnlich kann die Trennung der Verantwortlichkeiten in Lese- und Schreibmodelle in Banken- oder Börsensystemen, in denen die Transaktionsverarbeitung präzise sein muss und das Reporting zugleich die Aggregation großer Datenmengen erfordert, die Stabilität des Systems verbessern. CQRS bewährt sich hervorragend auch in der Microservice-Architektur und erlaubt eine bessere Skalierbarkeit einzelner Komponenten. Zu beachten ist jedoch, dass seine Umsetzung in einfachen Anwendungen unnötig kompliziert sein und zu erhöhten Wartungskosten führen kann. Vor seiner Implementierung sollten die geschäftlichen und technischen Anforderungen des Systems sorgfältig analysiert werden, um eine überflüssige Komplizierung der Architektur zu vermeiden.
Vorteile und Grenzen der CQRS-Implementierung
CQRS besitzt eine Reihe von Vorteilen, die Entwickler komplex strukturierter Systeme anziehen. Es ermöglicht unter anderem die unabhängige Skalierbarkeit von Commands und Queries, was besonders in Systemen hilfreich ist, in denen die Last ungleichmäßig verteilt ist. Die Polarisierung dieser Verantwortlichkeiten sorgt zudem für höhere Flexibilität beim Systementwurf und eine einfachere Implementierung neuer Funktionen. Die Grenzen von CQRS ergeben sich vor allem aus seiner Komplexität. Seine Implementierung ist deutlich komplizierter als bei klassischen Ansätzen und erfordert ein erfahrenes Entwicklerteam. Darüber hinaus kann der Einsatz von CQRS zu erhöhten Wartungskosten und Schwierigkeiten bei der Synchronisation der Zustände zwischen Query- und Command-Modellen führen.
CQRS im Kontext von Microservices
Der Einsatz des CQRS-Musters in der Microservice-Architektur eröffnet neue Möglichkeiten für die effektive Verwaltung komplexer Systeme. Im Microservice-Umfeld, in dem jeder Service für eine bestimmte Funktionalität oder einen bestimmten Datensatz zuständig ist, fügt sich CQRS natürlich in diese Modularität ein und erlaubt die Trennung von Schreiboperationen (Commands) von Leseoperationen (Queries). Diese Trennung trägt nicht nur zur Steigerung von Performance und Skalierbarkeit durch die Optimierung von Datenbanken und Ressourcen für unterschiedliche Operationsarten bei, sondern erleichtert auch die Verwaltung der Datenkonsistenz in verteilten Systemen. Darüber hinaus erlaubt der Einsatz von CQRS in Microservices einen flexibleren Ansatz zur Verwaltung von Transaktionen und erhöht die Fehlertoleranz des Systems, was in weitläufigen, verteilten Umgebungen entscheidend ist. Durch den Einsatz von CQRS können Entwicklerteams die Komplexität von Microservice-Systemen besser handhaben, was sich in einer höheren Dienstqualität und einer besseren Performance der gesamten Architektur niederschlägt.
CQRS und andere Entwurfsmuster: Vergleich und Kontraste
Command Query Responsibility Segregation hebt sich von anderen Entwurfsmustern durch seinen einzigartigen Ansatz zur Segregation von Lese- und Schreiboperationen ab. Im Gegensatz zu klassischen Mustern wie MVC (Model-View-Controller) oder CRUD (Create, Read, Update, Delete), die nicht zwischen Lese- und Schreiboperationen auf architektonischer Ebene unterscheiden, führt CQRS eine deutliche Aufteilung ein und weist jedem dieser Operationstypen eigene Modelle zu. Dadurch können auf CQRS basierende Systeme skalierbarer und einfacher zu warten sein, besonders in komplexen Umgebungen, in denen Lesevorgänge die Schreibvorgänge deutlich übersteigen. Diese Aufteilung ermöglicht auch eine Performance-Optimierung durch unabhängige Skalierung der Lese- und Schreibschichten. Bei Mustern wie Event Sourcing hingegen, das häufig mit CQRS zusammenarbeitet, liegt der Fokus auf der Aufzeichnung von Zustandsänderungen der Anwendung als Sequenz von Ereignissen, was einen anderen Mechanismus zur Zustandsverwaltung darstellt als klassische Datenbank-Aktualisierungen. Obwohl CQRS in passenden Kontexten erhebliche Vorteile bietet, kann seine Implementierung komplexer sein und ein tieferes Verständnis der vorherrschenden Geschäftslogik erfordern, was im Kontrast zu den direkteren Ansätzen steht, die andere Entwurfsmuster bieten.
Häufigste Fehler und Herausforderungen bei der Einführung von CQRS
Auch wenn CQRS ein leistungsfähiges Architekturmuster ist, bringt seine Einführung Herausforderungen und das Risiko von Fehlern mit sich. Eines der häufigsten Probleme ist die übermäßige Verkomplizierung des Systems – CQRS ist keine universelle Lösung, und sein Einsatz in einfachen Anwendungen kann zu unnötigem technischem Overhead führen und die Entwicklung erschweren. Eine weitere Herausforderung ist die Sicherstellung der Datenkonsistenz zwischen Schreib- und Lesemodell. In Systemen, die auf Event Sourcing basieren, kann das zu Problemen bei der Propagierung von Ereignissen und zur Notwendigkeit führen, deren Versionierung zu verwalten.
Darüber hinaus kann die Synchronisation der Modelle Verzögerungen erzeugen, was die Implementierung von Strategien zur Datenbehandlung im Zustand der Eventual Consistency (ultimative Konsistenz) erfordert. Eine schlecht entworfene Architektur kann außerdem zu einer zu starken Zersplitterung des Codes führen, was dessen Wartung erschwert. Ein Fehler ist auch das Fehlen geeigneter Mechanismen zur Fehlerbehandlung und zum Monitoring von Ereignissen, was Schwierigkeiten bei der Diagnose von Problemen im laufenden System verursachen kann. Um diese Fallstricke zu vermeiden, sollte der Einführung von CQRS eine gründliche Anforderungsanalyse sowie konzeptionelle Tests vorausgehen, die bewerten, ob es im jeweiligen Fall tatsächlich Nutzen bringt.
Werkzeuge und Technologien, die die CQRS-Implementierung unterstützen
Die Implementierung des Command-Query-Responsibility-Segregation-Musters wird durch eine Reihe von Werkzeugen und Technologien unterstützt, die die Verwaltung getrennter Pfade für Schreiboperationen (Commands) und Leseoperationen (Queries) erleichtern. Frameworks wie Axon und MediatR im Umfeld von .NET oder CQRS Kit und Node-CQRS in Node.js bieten fertige Mechanismen zur Definition und Verarbeitung von Commands und Queries sowie die notwendige Unterstützung für Event Sourcing. Für auf Microservices basierende Systeme können Werkzeuge wie Kafka zur effektiven Verwaltung der Kommunikation und des Ereignisflusses zwischen verschiedenen Systemteilen eingesetzt werden. Datenbanken, die ereignisbasierte Modellierung natürlich unterstützen oder für schnelle Lesevorgänge optimiert sind, wie Event Store oder Apache Cassandra, sind ebenfalls entscheidend für eine effektive CQRS-Implementierung. Zusätzlich können Containerisierung und Orchestrierung mithilfe von Werkzeugen wie Docker und Kubernetes bei der Skalierung und Verwaltung komplexer Umgebungen helfen, die CQRS nutzen.
FAQ
FAQ – häufig gestellte Fragen zu CQRS
CQRS steht für Command Query Responsibility Segregation, also die Trennung der Verantwortlichkeiten für Befehle und Abfragen.
Im klassischen Ansatz (CRUD) bedient dieselbe Schicht sowohl Lese- als auch Schreibvorgänge. Bei CQRS werden diese beiden Verantwortlichkeiten getrennt, was die unabhängige Optimierung jeder von ihnen ermöglicht.
CQRS bewährt sich in komplexen Systemen, in denen sich die Geschäftslogik für Schreib- und Lesevorgänge erheblich unterscheidet oder in denen hohe Performance und Skalierbarkeit gefordert sind.
Nein. CQRS und Event Sourcing können gemeinsam eingesetzt werden, müssen es aber nicht. CQRS lässt sich auch ohne Event Sourcing implementieren.
- Bessere Trennung der Verantwortlichkeiten
- Möglichkeit der unabhängigen Skalierbarkeit von Lese- und Schreibvorgängen
- Größere Flexibilität beim Entwurf von Datenmodellen
Nein. In einfachen Anwendungen kann es unnötige Komplexität einführen. CQRS ergibt vor allem dort Sinn, wo die Komplexität des Systems es rechtfertigt.
In der Praxis werden getrennte Modelle und Schichten für Abfragen (Query) und Befehle (Command) verwendet, häufig auch verschiedene Datenbanken oder Datenschemata.
CQRS lässt sich in vielen Sprachen und Frameworks umsetzen – z. B. .NET, Java, Node.js. Hilfreich sind auch Bibliotheken wie MediatR, Axon Framework oder MassTransit.