

Weniger abgebrochene Anträge dank eines einfacheren Weges zur Finanzierung
Kunde: Horyzont Capital
Branche: FinTech
KI
KI im Finanzwesen trifft immer häufiger die erste Entscheidung anstelle eines Menschen – bei der Bonitätsprüfung, der Betrugserkennung oder der Qualifizierung von Anträgen. Wir erklären, wie solche Systeme funktionieren, welche Daten sie nutzen und wo die realen Schwierigkeiten der Implementierung liegen.
Tomasz Kozon
CEO
23. Sept. 2026
KI im Finanzwesen ist längst kein reines Werkzeug mehr zur nachträglichen Datenanalyse. Immer häufiger trifft sie die erste Entscheidung – ob ein Kredit gewährt wird, ob eine Transaktion verdächtig erscheint, ob der Antrag eines Kunden für die weitere Bearbeitung in Frage kommt. Der Mensch überwacht den Prozess weiterhin, doch das Modell bewertet den Fall in Sekundenbruchteilen, bevor jemand überhaupt einen Blick darauf wirft. Für eine Bank, einen Fonds oder ein Kreditunternehmen bedeutet das eine konkrete operative Veränderung. Ein Antrag, der früher in der Warteschlange auf einen Analysten wartete, erhält heute sofort eine erste Einschätzung. Das Team kümmert sich um Ausnahmen und Grenzfälle, nicht um jeden Antrag einzeln. Das verlagert die Arbeit der Menschen weg von der Routine hin zu Entscheidungen, die tatsächlich Erfahrung erfordern.
Es lohnt sich, gleich zu Beginn zwei Automatisierungsebenen zu unterscheiden, denn in Gesprächen werden sie oft vermischt. Die erste ist die Entscheidungsunterstützung – das Modell berechnet einen Score, ein Risiko oder eine Empfehlung, doch das letzte Wort hat immer der Mensch. Die zweite ist die vollautomatische Entscheidung – das System akzeptiert oder lehnt den Antrag selbst ab, ohne Beteiligung eines Analysten, im Rahmen vorab festgelegter Regeln.
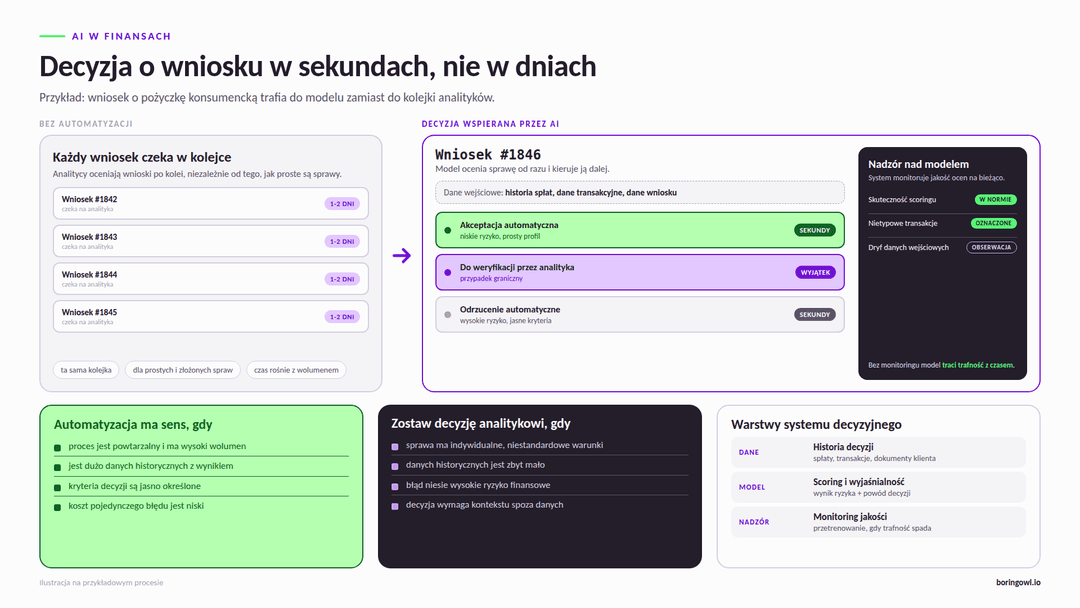
In der Praxis beginnen die meisten Institute mit der ersten Ebene und bewegen sich schrittweise in Richtung der zweiten – dort, wo das Fehlerrisiko gering und das Volumen hoch ist. Ein kleiner Verbraucherkredit mit standardisiertem Kundenprofil eignet sich schneller für die vollständige Automatisierung als ein großer Firmenkredit mit individuellen Bedingungen. Letzterer bleibt in der Regel beim unterstützenden Modell, bei dem die KI die Analyse vorbereitet und die Entscheidung ein Kreditausschuss trifft. Die Grenze zwischen diesen Ebenen bestimmt weniger die Technologie selbst als vielmehr die Risikobereitschaft des jeweiligen Instituts und die Qualität der Daten, auf denen das Modell lernt. Je mehr historische Fälle mit eindeutigem Ergebnis vorliegen – zurückgezahlt oder nicht, Transaktion war Betrug oder nicht – desto leichter lässt sich dem Modell eine vollautomatische Entscheidung anvertrauen.
Wie eine Organisation überhaupt zu solchen Festlegungen gelangt, ist ein eigenes Thema, das wir im Zusammenhang mit dem Entscheidungsprozess in der IT ausführlicher beschrieben haben – dort, wo die Entscheidung die Wahl einer Technologie betrifft, ähnelt der Mechanismus zur Festlegung von Verantwortlichkeiten sehr dem bei der Einführung von Automatisierung.
Die ausgereifteste Anwendung von KI im Finanzwesen ist die Bonitätsprüfung. Statt eines einzelnen Kennwerts, der einmal zu Beginn berechnet wird, kombiniert modernes Scoring Daten aus vielen Quellen – Rückzahlungshistorie, Transaktionsdaten vom Konto, mitunter auch Verhaltensdaten wie die Art, ein Formular auszufüllen. Das Modell nutzt Techniken des maschinellen Lernens und lernt an Tausenden früherer Entscheidungen, indem es nach Mustern sucht, die in einer herkömmlichen Scorecard nur schwer zu erkennen sind. Den Mechanismus beschreibt ein Entscheidungsbaum gut – eine der einfacheren, aber nach wie vor eingesetzten Methoden des maschinellen Lernens, bei der das Modell die Daten entlang aufeinanderfolgender Kriterien aufteilt, bis es zu einer konkreten Empfehlung gelangt. In der Praxis stützen sich Banken nur noch selten auf ein einziges solches Modell, sondern kombinieren die Ergebnisse mehrerer Ansätze – von einfachen Bäumen bis hin zu komplexeren Netzen – und berücksichtigen deren Übereinstimmung.
Der Effekt für den Kunden ist messbar. Ein Kreditantrag, der früher ein oder zwei Tage auf einen Analysten wartete, erhält heute binnen Sekunden eine erste Entscheidung. Das bedeutet nicht, dass jeder Antrag automatisch angenommen wird – Grenzfälle gelangen weiterhin zu einem Menschen, doch ihre Zahl ist deutlich geringer als bei einer vollständig manuellen Analyse.
Die zweithäufigste Anwendung neben dem Scoring ist Fraud Detection – das Erkennen von Transaktionen, die vom typischen Verhalten eines Kunden abweichen. Das Modell lernt das Profil jedes Kontos: wie viel üblicherweise ausgegeben wird, wo, zu welcher Uhrzeit, über welche Kanäle. Eine Transaktion, die nicht zu diesem Muster passt, erhält einen höheren Risiko-Score und gelangt zur zusätzlichen Prüfung, bevor sie bestätigt wird. Der Unterschied zu älteren Systemen aus Geschäftsregeln – etwa „Transaktion über fünftausend Złoty im Ausland blockieren“ – ist grundlegend. Eine Regel ist starr und leicht zu umgehen, sobald der Betrüger sie kennt. Ein laufend lernendes Modell passt sich an neue Betrugsmuster an, wobei dies die stetige Zufuhr frischer Daten und regelmäßiges Nachtrainieren erfordert.
Eine ähnliche Logik, nur in einem anderen Sektor, haben wir im Zusammenhang mit KI im Versicherungswesen beschrieben, wo Modelle Schadensmeldungen auf die Wahrscheinlichkeit eines Missbrauchs hin bewerten. Der Mechanismus ist vergleichbar – in beiden Fällen geht es darum, normales Verhalten von einer Abweichung zu unterscheiden, die die Aufmerksamkeit eines Menschen verdient.
Bevor ein Antrag zur Risikobewertung gelangt, muss jemand – oder etwas – prüfen, ob er überhaupt vollständig und korrekt ist. Diese Aufgabe eignet sich gut für die Automatisierung, denn sie ist repetitiv und hat klare Kriterien: fehlendes Dokument, Dateninkonsistenz, überschrittene Altersgrenze. Große Sprachmodelle können vom Kunden eingereichte Dokumente lesen, die benötigten Daten daraus extrahieren und ihre Übereinstimmung mit dem eingereichten Antrag prüfen, statt in jeder Phase einen Mitarbeiter einzubinden. Erst ein Antrag, der diese Vorqualifizierung bestanden hat, gelangt zur eigentlichen Risikobewertung. Ein solcher Ansatz fügt sich gut in eine Architektur auf Basis von LangChain ein, einem Framework, das Sprachmodelle mit externen Datenquellen und Kundendokumenten verbindet.
Die Vorqualifizierung endet nicht bei den Dokumenten. Immer häufiger umfasst sie auch den ersten Kontakt mit dem Kunden – ein KI-Chatbot oder KI-Voicebot sammelt grundlegende Informationen zum Finanzbedarf, bevor der Fall zu einem Berater gelangt, der sich nur noch um Fälle kümmert, die ein Gespräch erfordern.
Das sollte man von der einfacheren robotergestützten Prozessautomatisierung unterscheiden, die Daten nach starren Regeln zwischen Systemen überträgt, ohne irgendeine Bewertung vorzunehmen. Beide Ansätze arbeiten oft nebeneinander – RPA entlastet Mitarbeiter von mechanischen Tätigkeiten, während KI-Modelle das übernehmen, was eine tatsächliche Einschätzung der Situation erfordert.
Kunde: Horyzont Capital
Branche: FinTech
Neben Entscheidungen zu einzelnen Kunden unterstützt KI im Finanzwesen auch Entscheidungen auf der Ebene des gesamten Instituts – die Risikobewertung des Kreditportfolios, die Verlustprognose oder das Erkennen von Warnsignalen in operativen Daten. Dieser Bereich liegt näher an der Analytik als an der Automatisierung einzelner Transaktionen, baut aber auf denselben Fundamenten auf: hochwertigen Daten und regelmäßig überprüften Modellen.
Den breiteren Kontext dieses Themas behandeln wir im Artikel über operative Risiken – Gefahren, die aus Fehlern in Systemen, Prozessen oder beim Menschen entstehen und in einem Finanzinstitut unmittelbar auf das Finanzergebnis durchschlagen. Prädiktive Modelle helfen, solche Signale frühzeitig aufzugreifen, bevor sie zu einem realen Problem anwachsen.
Der Aufbau eines Systems, das Finanzentscheidungen automatisiert, beginnt mit den Daten – ihrer Erfassung, Bereinigung und Zusammenführung zu einem stimmigen Bild des Kunden oder der Transaktion. Die Daten stammen in der Regel aus mehreren Quellen zugleich: dem Bankensystem, der Transaktionshistorie, mitunter externen Datenbanken, zu denen das Institut Zugang hat. Bevor sie das Modell erreichen, müssen sie eine Normalisierungsschicht durchlaufen, die Formate vereinheitlicht und Fehler bereinigt.
Das Modell selbst ist meist der kleinste, wenn auch sichtbarste Teil des Projekts. Wichtiger ist das, was darum herum geschieht – das Monitoring der Vorhersagequalität, die Versionierung der Modelle und die Möglichkeit, nachzuvollziehen, warum eine konkrete Entscheidung so und nicht anders ausgefallen ist. Im Finanzwesen hat die Erklärbarkeit von Entscheidungen praktische, nicht nur formale Bedeutung: Ein Analyst, dem ohne Begründung eine Antragsablehnung vorgelegt wird, kann nicht beurteilen, ob das Modell sich irrt.
Zur Speicherung und Durchsuchung großer Datenbestände – etwa historischer Transaktionsbeschreibungen oder Kundendokumente – eignen sich Vektordatenbanken wie Qdrant gut; sie ermöglichen es, schnell ähnliche Fälle aus der Vergangenheit zu finden und als Kontext für das Modell zu nutzen, das die aktuelle Entscheidung trifft.
Sprachmodelle selbst, etwa aus der Familie von Anthropic, kommen immer häufiger in diesen Stack als Schicht hinzu, die unstrukturierte Daten – Dokumente, Beschreibungen, Korrespondenz – mit dem Rest des Systems verbindet.
Die Integration mit den Quellsystemen ist meist der zeitaufwendigste Teil des Projekts, denn Finanzinstitute verfügen selten über ein einziges, einheitliches System – häufiger über mehrere, die über Jahre hinzugefügt wurden. Eine gut entworfene SaaS-Architektur erleichtert diese Verknüpfung, macht aber selten die Entwicklung dedizierter Konnektoren für bestimmte Legacy-Systeme überflüssig.
Wo die Automatisierung auch interne operative Prozesse des Instituts umfasst, etwa Abrechnungen oder Reporting, bewährt sich ein dediziertes ERP-System, das zur einzigen Quelle der Wahrheit für die Daten wird, die das Modell speisen.
Das größte Problem stellt selten das Modell selbst dar. Es ist die Qualität und Verfügbarkeit der historischen Daten, auf denen es überhaupt trainiert werden kann. Ein Institut, das jahrelang Entscheidungen manuell getroffen und keine Begründungen festgehalten hat, verfügt über wenig Material zum Trainieren des Modells – es muss mit dem Sammeln von Daten beginnen, bevor die Automatisierung möglich wird.
Die zweite Herausforderung ist der Erhalt des Modells über die Zeit. Kundenverhalten und Betrugsmuster ändern sich, sodass ein vor einem Jahr trainiertes Modell heute schlechtere Entscheidungen treffen kann als zu Beginn. Das erfordert ein kontinuierliches Monitoring der Vorhersagequalität und einen Prozess, der einen Rückgang der Treffgenauigkeit signalisiert, bevor Kunden oder die interne Revision ihn bemerken.
Die dritte, häufiger übersehene Frage ist die Sicherheit der Entscheidungssysteme selbst. Ein Modell, das Kreditanträge automatisch annimmt, ist ein attraktives Ziel – ein Fehler in seinen Sicherungen kann mehr kosten als ein Fehler in der Risikobewertung selbst. Deshalb sollten Projekte dieser Art von Anfang an gemeinsam mit einem Sicherheitsaudit der Anwendung geführt werden, ähnlich den im Rahmen unserer Sicherheitsleistungen beschriebenen.
Eine vollständige Automatisierung aller Entscheidungen auf einmal ist ein schlechter Ausgangspunkt. Besser ist es, einen Prozess mit hohem Volumen und vergleichsweise geringem Risiko der Einzelentscheidung auszuwählen – etwa die Vorqualifizierung einfacher Anträge – und dafür ein funktionierendes System aufzubauen, bevor der Umfang auf komplexere Entscheidungen ausgeweitet wird.
Es lohnt sich, mit einem Workshop zu beginnen, der präzisiert, welche Entscheidungen überhaupt für eine Automatisierung in Frage kommen und welche besser beim Menschen bleiben – eine Aufgabe, die dem nahekommt, womit wir uns im Rahmen von Product Discovery befassen. Erst auf dieser Grundlage lässt sich die Datenarchitektur sinnvoll planen und entscheiden, welche Elemente von Grund auf gebaut und welche auf fertigen Komponenten aufgesetzt werden.
Ein solches Projekt endet selten mit einer einzigen Implementierung. Das Modell benötigt Wartung, die Daten wachsen und der Automatisierungsumfang weitet sich in der Regel mit dem Vertrauen in das System aus – das ist einer der Gründe, warum wir es als Teil einer umfassenderen digitalen Transformation des Instituts behandeln und nicht als einzelnes Technologieprojekt.
Wenn Ihr Institut die Automatisierung eines Entscheidungsprozesses erwägt, beschreiben Sie uns dieses Projekt über das Kontaktformular von Boring Owl.
FAQ
Blog
Tarifierung von Risiko und Schaden, Aufdeckung von Betrug, Bearbeitung von Meldungen vom ersten Kontakt bis zur Auszahlung. Wo KI in Versicherungen einen messbaren Effekt bringt, was die Vorschriften automatisieren lassen und wann es besser ist, bei Regeln und einem erfahrenen Sachbearbeiter zu bleiben.
Das Agentic Commerce Protocol (ACP) von OpenAI und Stripe beschreibt, wie ein KI-Agent im Namen eines Kunden im Online-Shop eine Bestellung aufgibt. Wir zerlegen es in sechs Begriffe – vom Produkt-Feed bis zum Bestell-Webhook – und zeigen, was die erste Implementierung in ChatGPT für einen polnischen Shop bedeutet.
Die KI-Einführung im Unternehmen beginnt selten mit dem Kauf eines großen Systems. Wir zeigen sie als fünf Stufen – von Regeln für Werkzeuge, die Mitarbeitende bereits nutzen, bis zu KI im eigenen Produkt – und erklären, wie Sie den ersten Prozess auswählen und woran Sie erkennen, dass sich der Pilot gelohnt hat.
Künstliche Intelligenz im Kundenservice hat den Weg von Bots mit Buttons zu KI-Agenten zurückgelegt, die Anliegen eigenständig in den Firmensystemen erledigen. Wir zeigen anhand einer Kundenanfrage, wie vier Generationen von Bots antworten, wann ein Mensch nötig ist, wie man Ergebnisse misst und wie man die Implementierung beginnt.
Künstliche Intelligenz in der Hotellerie ist heute ein Set konkreter Werkzeuge für jede Etappe der Gästereise, von Fragen vor der Buchung bis zu Bewertungen nach der Abreise. Wir teilen sie in drei Gruppen: das, was sich bereits rechnet, das, was Vorbereitung erfordert, und das, was vorerst vor allem ein Versprechen ist.
Personalisiertes Lernen, adaptives E-Learning und KI-Tutoren – künstliche Intelligenz in der Bildung verlässt die Pilotphase. Wir zeigen, was heute bereits funktioniert und womit Sie beginnen sollten, wenn Sie KI in Firmenschulungen einführen möchten.