
Weniger abgebrochene Anträge dank eines einfacheren Weges zur Finanzierung
Kunde: Horyzont Capital
Branche: FinTech
KI
Tarifierung von Risiko und Schaden, Aufdeckung von Betrug, Bearbeitung von Meldungen vom ersten Kontakt bis zur Auszahlung. Wo KI in Versicherungen einen messbaren Effekt bringt, was die Vorschriften automatisieren lassen und wann es besser ist, bei Regeln und einem erfahrenen Sachbearbeiter zu bleiben.
Tomasz Kozon
CEO
16. Aug. 2026
Montag, halb neun. Im System warten mehrere Hundert Meldungen vom Wochenende: Parkplatzrempler, überflutete Badezimmer, eingeschlagene Scheiben, zwei Krankenhausaufenthalte. Die meisten davon sind einfach und ehrlich, und trotzdem durchläuft jede denselben Pfad. Der Sachbearbeiter öffnet die Anhänge, überträgt die Daten in das System, sieht sich die Fotos an, fordert fehlende Unterlagen an. Irgendwo in diesem Stapel liegt ein Schaden mit einem Foto, das vor einem halben Jahr bereits einer anderen Meldung beigefügt wurde. Niemand wird das bemerken, weil niemand die Zeit hat, zu vergleichen. Gerade an einem solchen Montag sieht man am besten, wofür KI in Versicherungen wirklich nützlich ist.
Die im Titel genannten Bereiche haben mehr gemeinsam, als die Namen der Abteilungen vermuten lassen. Automatische Tarifierung (von Prämie oder Schaden) ist die Prognose eines Betrags auf Basis von Daten. Betrugserkennung ist die Suche nach Fällen, die vom Muster abweichen. Schadenbearbeitung besteht zu einem großen Teil im Lesen von Dokumenten und im Treffen wiederkehrender Entscheidungen. In jedem dieser Bereiche kann ein Modell einen Teil der Arbeit übernehmen. In keinem sollte es ohne Aufsicht arbeiten.
Im Folgenden beschreiben wir, wie das aus Sicht der Implementierung aussieht: welche Daten nötig sind, was im Lichte der polnischen und europäischen Vorschriften automatisiert werden darf, wo sich Modelle irren und wann es besser ist, bei Regeln und einem erfahrenen Sachbearbeiter zu bleiben. Wir schreiben aus der Perspektive eines Teams, das Software für Versicherungsunternehmen entwickelt und sie mit den Systemen verbindet, die diese Unternehmen bereits haben.
Die einfachste Erklärung liegt in den Zahlen. Laut einem Bericht des Polnischen Versicherungsverbands (PIU) vom Juli 2026 haben Versicherer im Jahr 2025 Straftaten im Gesamtwert von fast 800 Mio. zł aufgedeckt, 18 % mehr als im Vorjahr (675 Mio. zł). In der Schadenversicherung betrafen rund 64 % der aufgedeckten Fälle den Kfz-Bereich: vorgetäuschte Kollisionen, absichtlich herbeigeführte Unfälle, fingierte Verletzungen und vorgetäuschte Autodiebstähle. Und das ist nur das, was ans Licht gekommen ist. Insurance Europe schätzt, dass aufgedeckter und nicht aufgedeckter Betrug zusammen rund 10 % aller Entschädigungsausgaben in Europa ausmachen. Auch die Technik der Betrugsversuche selbst hat sich verändert. Derselbe PIU-Bericht weist darauf hin, dass Täter massenhaft frei zugängliche KI-Werkzeuge nutzen, um medizinische Unterlagen zu fälschen. Eine gefälschte Entlassungsbestätigung aus dem Krankenhaus oder eine Rechnung für eine Reparatur entsteht in wenigen Minuten und sieht korrekt aus. Eine Kontrolle, die darauf beruht, dass der Sachbearbeiter „etwas Seltsames bemerkt“, reicht nicht mehr aus, wenn die Fälschung keine Tippfehler und keine schiefen Stempel enthält.
Auf der anderen Seite steht der Kunde, der auf sein Geld wartet. Art. 817 des polnischen Zivilgesetzbuchs gibt dem Versicherer 30 Tage ab Eingang der Schadenmeldung, und wenn die Umstände einer Klärung bedürfen, 14 Tage ab dem Zeitpunkt, zu dem sie bei gehöriger Sorgfalt geklärt werden konnten. Der unstreitige Teil der Leistung muss innerhalb der ersten Frist ausgezahlt werden. Der Kunde vergleicht die Bearbeitung jedoch nicht mit dem Gesetzbuch. Er vergleicht sie mit der Bank, in der eine Überweisung in wenigen Sekunden durchgeht.
Die Branche reagiert bereits. In einer Untersuchung der EIOPA, der europäischen Versicherungsaufsicht, die bei 209 Unternehmen aus 22 Staaten durchgeführt und 2024 veröffentlicht wurde, gaben 50 % der Schaden- und 24 % der Lebensversicherer an, KI zu nutzen. Weitere 30 % bzw. 39 % planten eine Implementierung innerhalb von drei Jahren. Die am häufigsten genannten Anwendungen sind Kundenservice, Betrugserkennung, Schadenbearbeitung, Vertrieb und Tarifierung. Die Daten haben einen Vorbehalt: Sie beschreiben den Stand von 2022, vor der Verbreitung generativer Modelle.
Kunde: Horyzont Capital
Branche: FinTech
Kunde: Jabłoński & Wspólnicy
Branche: LegalTech
Das Wort „Tarifierung“ bedeutet in Versicherungen zwei unterschiedliche Dinge. Das erste ist die Risikobewertung, also die Festsetzung der Prämie beim Abschluss des Vertrags. Das zweite ist die Schadenbemessung, also die Festlegung, was dem Geschädigten zusteht. Beides lässt sich durch Modelle unterstützen, doch jeder Fall erfordert andere Daten und birgt ein anderes Fehlerrisiko.
Der Tarif ist in der Regel ein statistisches Modell, das von Aktuaren aufgebaut wird, meistens ein verallgemeinertes lineares Modell (GLM). Das ist eine klassische Methode, bei der jeder Faktor, etwa das Fahrzeugalter oder die Postleitzahl, ein offen ausgewiesenes und nachprüfbares Gewicht hat. Maschinelles Lernen ersetzt diesen Tarif nicht, sondern ergänzt ihn. Ensemble-Modelle, also solche, die die Ergebnisse vieler einfacher Entscheidungsbäume verknüpfen, wie Gradient Boosting, erkennen selbst Zusammenhänge, die in einem GLM niemand im Voraus festgelegt hat. Ein junger Fahrer in einer großen Stadt verursacht andere Schäden als ein junger Fahrer auf dem Land, und allein die Variable „Alter“ zeigt das nicht. In der Praxis schlägt ein Modell des maschinellen Lernens den Aktuaren am häufigsten vor, in welchen Segmenten der Tarif falsch liegt, statt die Prämie selbstständig zu berechnen. Der Grund ist einfach. Ein Tarif muss gegenüber Aufsicht und Kunde begründet werden können, und „so kam es aus dem Modell“ ist keine Begründung.
Einen größeren Effekt als der Austausch des Algorithmus bringen oft neue Datenquellen. Bei Immobilienversicherungen sind das Standortdaten, etwa die Entfernung zum Fluss und die Überschwemmungshistorie der Umgebung. Ähnlich funktionieren automatische Modelle zur Immobilienbewertung, die der Markt für Hypothekenkredite nutzt. In der Kfz-Versicherung ist eine solche Quelle die Telematik, also Daten zum Fahrstil aus einer App oder einem Gerät im Fahrzeug. Jede neue Quelle wirft jedoch die Frage nach der Zustimmung des Kunden auf und danach, ob die Daten in einer automatischen Entscheidung verwendet werden dürfen. Darauf kommen wir im Teil zu den Vorschriften zurück.
Bei Kfz-Schäden ist der erste „Gutachter“ immer häufiger eine App. Der Kunde fotografiert das Fahrzeug nach Anweisungen auf dem Bildschirm, und die Bilderkennung durch KI weist beschädigte Teile aus und schlägt den Arbeitsumfang vor, von der Lackierung bis zum Austausch von Teilen. Auf dieser Grundlage berechnet ein Kalkulationssystem den Betrag. Für typische Karosserieschäden an gängigen Fahrzeugmodellen funktioniert das gut. Schlechter ist es bei Schäden, die auf dem Foto nicht sichtbar sind, wie ein gerissener Halter hinter der Stoßstange oder ein beschädigter Radarsensor. Ein vernünftig eingerichteter Prozess behandelt die Schätzung anhand von Fotos daher als Vorschlag. Der Kunde kann sie sofort annehmen, und bei einem höheren Betrag oder geringer Modellsicherheit geht der Fall in die Besichtigung. Eine überflutete Wohnung oder ein Brand ist eine andere Situation, denn Fotos sagen hier weniger aus. Mehr bringt das Auslesen von Rechnungen und Kostenvoranschlägen der Handwerker und anschließend der Vergleich der Preise mit der Historie ähnlicher Schäden in derselben Region. Das Modell bewertet dann vor allem die Plausibilität der Beträge.
Die Aufdeckung von Betrug, englisch Fraud Detection, beruht nicht darauf, dass ein Modell „weiß“, wer lügt. Sie beruht darauf, jedem Schaden eine Risikobewertung zu geben und die verdächtigsten an Spezialisten weiterzuleiten. Das ist eine klassische Aufgabe der prädiktiven Analyse. Die Entscheidung über die Ablehnung einer Auszahlung wegen des Verdachts auf Betrug sollte bei einem Menschen liegen, der das Beweismaterial kennt.
Die meisten Versicherer verfügen bereits über ein Regelsystem, sogenannte Red Flags. Ein Schaden, der wenige Tage nach Vertragsabschluss gemeldet wird, eine Kollision in der Nacht ohne Zeugen, eine Versicherungssumme, die kurz vor dem Brand erhöht wurde, ein Meldender, der sich nicht an die Einzelheiten des Ereignisses erinnert, aber die Versicherungsbedingungen hervorragend kennt. Regeln sind transparent und leicht zu erklären. Dafür haben sie zwei Nachteile: Sie erzeugen viele Alarme und werden schnell bekannt. Wer einmal eine Ablehnung erhalten hat, weiß, was er beim nächsten Mal vermeiden muss. Ein Modell des maschinellen Lernens betrachtet Hunderte von Merkmalen gleichzeitig und bewertet ihre Kombination. Es lernt an historischen Schäden, die einst als Betrug bestätigt wurden. Hier liegt die erste Falle. Solche Fälle sind selten, und die vorhandenen zeigen vor allem Schemata, die das Team bereits erkennen konnte. Deshalb werden neben Modellen, die an Beispielen lernen, auch Anomalieerkennung eingesetzt, also die Suche nach Schäden, die vom Rest des Portfolios abweichen, ohne das fertige Etikett „Betrug“.
Organisierte Gruppen treten am häufigsten in der Beziehungsanalyse zutage. Dieselbe Telefonnummer bei fünf Schäden. Dieselbe Werkstatt bei Kollisionen derselben Fahrer. Ein Zeuge eines Rempelers als Verursacher eines anderen. Ein einzelner Schaden erregt keinen Verdacht, ein ganzes Netz schon. Technisch ist das ein Graph, in dem die Knoten Personen, Fahrzeuge, Adressen und Werkstätten sind und die Verbindungen gemeinsame Schäden darstellen. Solche Zusammenhänge werden erst dann sichtbar, wenn Daten aus dem Policen- und dem Schadensystem an einer Stelle zusammenlaufen.
KI wirkt hier auf beiden Seiten. Täter erzeugen Dokumente und bearbeiten Fotos, der Versicherer setzt ähnliche Techniken ein, um sie aufzuspüren. Einiges bringen einfache Tests: ob dasselbe oder ein sehr ähnliches Foto nicht bereits in einem anderen Schaden aufgetaucht ist und ob die Metadaten der Datei, etwa Aufnahmedatum und Koordinaten, mit der Beschreibung des Ereignisses übereinstimmen. Dokumente werden mit Vorlagen verglichen, die eine bestimmte medizinische Einrichtung oder Werkstatt zuvor ausgestellt hat. Die Erkennung von vollständig durch KI erzeugten Inhalten ist schwieriger. Das ist ein Wettlauf, in dem der Detektor meist einen Schritt hinter dem Generator bleibt, ähnlich wie bei Bildern und Aufnahmen vom Typ Deepfake. Wirksamer ist mitunter eine Prüfung an der Quelle: eine Anfrage beim Krankenhaus, ob es das betreffende Dokument ausgestellt hat, oder ein Abgleich der Daten mit Registern, zu denen der Versicherer Zugang hat.
Jeder als verdächtig markierte Schaden kostet. Zeit des Spezialisten und Nerven des Kunden, der sich meistens als ehrlich erweist und länger auf sein Geld wartet. Ein Modell, das mehr Betrugsfälle aufdeckt, aber die Zahl der Alarme verdoppelt, kann das Ergebnis in der Praxis verschlechtern, weil das Ermittlerteam die Warteschlange nicht abarbeitet. Die Alarmschwelle wird daher an die Kapazität des Teams und den Wert der Schäden angepasst. Die abstrakte „Trefferquote“ des Modells sagt hier wenig aus. Der einfachste Indikator zur Überwachung ist der Anteil der Alarme, die tatsächlich in der Aufdeckung eines Betrugs enden. Sinkt er, müssen Modell oder Regeln überprüft werden.
Die Schadenregulierung, also der gesamte Prozess von der Meldung bis zur Auszahlung, besteht zu einem großen Teil aus Arbeit mit Dokumenten und Gesprächen mit dem Kunden. Hier zahlt sich KI am schnellsten aus, weil die Wirkung sofort in der Bearbeitungszeit sichtbar wird.
Meldungen sind mitunter chaotisch. Der Kunde schreibt eine E-Mail ohne Policennummer und schickt die Fotos in drei getrennten Nachrichten. Ein KI-Chatbot, der Schadenmeldungen annimmt, fragt fehlende Daten nach, prüft die Police, erkennt die Schadenart und sagt sofort, welche Unterlagen benötigt werden. Geht der Fall über seinen Zuständigkeitsbereich hinaus, übergibt er das Gespräch an einen Berater zusammen mit dem, was er bereits festgestellt hat. Ein Teil der Kunden ruft lieber an, besonders kurz nach einem Unfall. Bei hohem Aufkommen an der Hotline erledigen dieselbe Arbeit Voicebots, die grundlegende Informationen aufnehmen und eine Meldung anlegen. Ein Gespräch mit jemandem im Schock oder nach einem schweren Unfall sollte man jedoch besser sofort an einen Menschen weiterleiten.
Rechnungen, Kostenvoranschläge, Entlassungsbestätigungen aus dem Krankenhaus, Polizeiprotokolle, Erklärungen der Verursacher. Klassisches OCR, also die Umwandlung eines Scans in Text, ist erst der Anfang. Ein Sprachmodell, also dieselbe Art von KI, auf der Chats wie ChatGPT beruhen, versteht, was was ist. Es weiß, dass der Betrag am unteren Rand einer Rechnung der Bruttowert ist, dass eine Diagnose in einer Krankenhausakte mit dem ICD-10-Code festgehalten wurde, dass das Datum auf dem Stempel vom Datum des Ereignisses abweicht und dass der Verursacher in der Erklärung seine Schuld einräumt. Daraus entstehen strukturierte Daten, die direkt in das Schadensystem gelangen.
Medizinische Unterlagen sind Daten einer besonderen Kategorie im Sinne der DSGVO, also unter anderem Informationen über die Gesundheit. Über die Wahl des Modells und des Verarbeitungsorts entscheidet dann ein Jurist in gleichem Maße wie ein Systemarchitekt. Die Anwendung selbst, durch die solche Daten laufen, sollte man vor dem Start einem Sicherheitsaudit der Anwendung unterziehen.
Ein Teil der Schäden braucht gar keinen Sachbearbeiter. Eine eingeschlagene Scheibe oder die Erstattung der Kosten eines Arztbesuchs im Rahmen des Policenlimits sind gute Beispiele. Wenn der Betrag niedrig, die Bedingungen klar, die Unterlagen vollständig und die Risikobewertung für Betrug niedrig ist, kann das System eine Entscheidung und die Auszahlung ohne menschliche Beteiligung vorbereiten. Eine solche Aufteilung der Fälle, Triage genannt, sorgt dafür, dass sich Sachbearbeiter mit Schäden befassen, bei denen ihre Erfahrung zählt. Die Schwelle für die automatische Auszahlung sollte zu Beginn niedrig angesetzt werden. Man hebt sie dann an, wenn Daten aus mehreren Monaten zeigen, dass die Entscheidungen des Automaten nicht von menschlichen abweichen.
Allgemeine Versicherungsbedingungen können mehrere Dutzend Seiten umfassen, und im Portfolio sind mehrere Versionen davon im Einsatz. Ein Assistent, der nach der Technik RAG aufgebaut ist, also ein Sprachmodell, das auf Basis angegebener Dokumente antwortet und nicht aus dem eigenen Gedächtnis, findet die passende Stelle und zeigt den Absatz, aus dem sie stammt. Der Sachbearbeiter entscheidet weiterhin. Er verliert nur keine halbe Stunde mehr mit der Suche nach einem Haftungsausschluss.
Derselbe Assistent hilft, Begründungen von Entscheidungen und Antworten auf Beschwerden zu formulieren. Unter einer Bedingung: Jeder Text, der an den Kunden geht, wird von einem Menschen gelesen und freigegeben. Sprachmodelle klingen auch dann sicher, wenn sie sich irren.
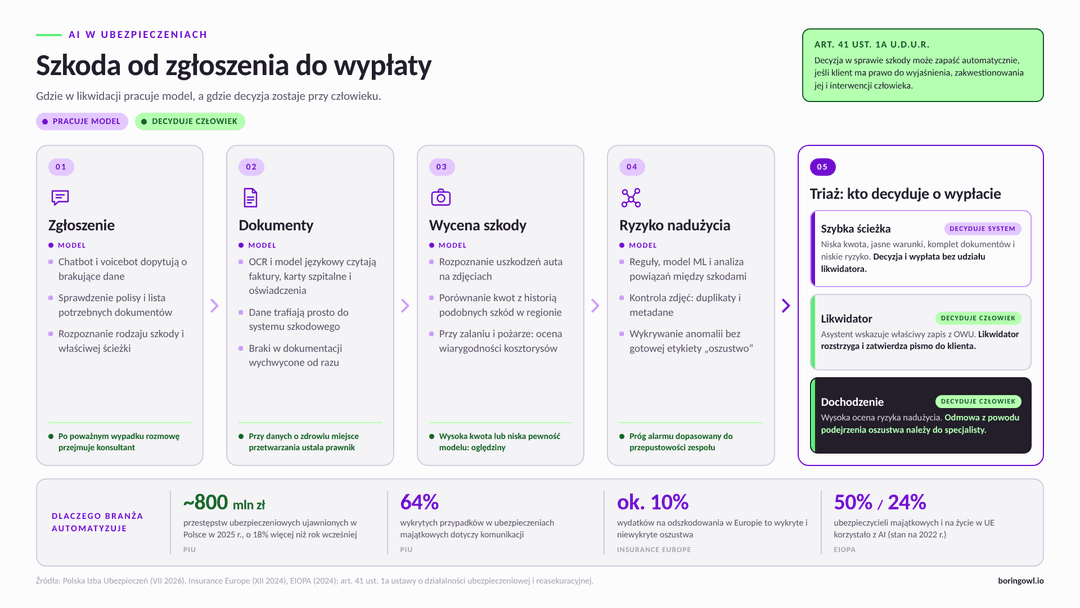
Ausgangspunkt ist Art. 22 DSGVO. Er gibt jedem das Recht, keiner Entscheidung unterworfen zu werden, die ausschließlich auf einer automatisierten Verarbeitung beruht, wenn sie ihm gegenüber rechtliche Wirkung entfaltet oder ihn in ähnlicher Weise erheblich beeinträchtigt. Der polnische Gesetzgeber hat für Versicherungen eine eigene Grundlage vorgesehen. Art. 41 Abs. 1a des Gesetzes über die Versicherungs- und Rückversicherungstätigkeit erlaubt dem Versicherungsunternehmen, solche Entscheidungen bei der Bewertung des Versicherungsrisikos und bei der Feststellung der Ursachen von Ereignissen und der Schadenhöhe zu treffen. Bedingung: Der Kunde hat das Recht auf Erläuterung der Grundlagen der Entscheidung, auf deren Anfechtung, auf Darlegung des eigenen Standpunkts und auf das Eingreifen eines Menschen.
Daraus ergeben sich konkrete Anforderungen an das System. Das Modell muss eine Spur hinterlassen, auf Grundlage welcher Daten und Faktoren es die Entscheidung getroffen hat, denn ohne das lässt sie sich nicht erläutern. Der Prozess muss einen Weg zur Einlegung eines Rechtsbehelfs bei einem Menschen vorsehen. Für automatisierte Entscheidungen dürfen zudem ausschließlich die in Abs. 1b dieses Artikels genannten Datenkategorien verwendet werden, sodass der Ansatz „schicken wir ins Modell alles, was wir haben“ ausscheidet.
Der AI Act, die EU-Verordnung über künstliche Intelligenz, zählt zu den Hochrisikosystemen jene, die der Risikobewertung und Preisfestsetzung in Lebens- und Krankenversicherungen natürlicher Personen dienen (Anhang III Nr. 5 lit. c). Kfz- und Schadenversicherungen sowie die Betrugserkennung stehen nicht auf dieser Liste. Den Geltungstermin für die Pflichten bei Systemen aus Anhang III hat die Verordnung (EU) 2026/1744, der sogenannte Digital Omnibus, verschoben, die am 27. Juli 2026 in Kraft getreten ist. Statt ab August 2026 gelten sie ab dem 2. Dezember 2027. Es geht dabei unter anderem um ein Risikomanagementsystem, die technische Dokumentation, die Protokollierung von Ereignissen und die menschliche Aufsicht.
Dass ein System nicht in die Kategorie des hohen Risikos gelangt ist, entbindet nicht von der Verantwortung. Die EIOPA hat in ihrer Stellungnahme vom August 2025 beschrieben, was die Aufsicht bei den übrigen KI-Anwendungen in Versicherungen erwartet: dokumentierte Data Governance, die Prüfung, ob die Ergebnisse nicht diskriminierend sind, Erklärbarkeit und eine echte menschliche Aufsicht.
Nicht jedes Problem in der Schadenabteilung ist ein Problem für ein Modell. Eine Implementierung rechnet sich in der Regel in fünf Situationen nicht:
Es kommt auch die umgekehrte Situation vor. Regeln funktionieren gut, und das Unternehmen will „KI dazu nehmen“, weil die Konkurrenz es tut. Die ehrlichste Empfehlung ist dann oft, die Regeln und das Reporting zu verfeinern. Weniger spektakulär. Dafür günstiger.
FAQ
Blog
Die Entwicklung des Kundenservice wird heute zu immer anspruchsvolleren Prozessen. Eine Schlüsselrolle spielen dabei Voicebots, die der Automatisierung im Unternehmen eine innovative Dimension verleihen. Sie ermöglichen eine effizientere Kommunikation und sparen wertvolle Zeit, sodass sie zu einem festen Bestandteil moderner Unternehmen werden.
Das Agentic Commerce Protocol (ACP) von OpenAI und Stripe beschreibt, wie ein KI-Agent im Namen eines Kunden im Online-Shop eine Bestellung aufgibt. Wir zerlegen es in sechs Begriffe – vom Produkt-Feed bis zum Bestell-Webhook – und zeigen, was die erste Implementierung in ChatGPT für einen polnischen Shop bedeutet.
Die KI-Einführung im Unternehmen beginnt selten mit dem Kauf eines großen Systems. Wir zeigen sie als fünf Stufen – von Regeln für Werkzeuge, die Mitarbeitende bereits nutzen, bis zu KI im eigenen Produkt – und erklären, wie Sie den ersten Prozess auswählen und woran Sie erkennen, dass sich der Pilot gelohnt hat.
Künstliche Intelligenz im Kundenservice hat den Weg von Bots mit Buttons zu KI-Agenten zurückgelegt, die Anliegen eigenständig in den Firmensystemen erledigen. Wir zeigen anhand einer Kundenanfrage, wie vier Generationen von Bots antworten, wann ein Mensch nötig ist, wie man Ergebnisse misst und wie man die Implementierung beginnt.
Künstliche Intelligenz in der Hotellerie ist heute ein Set konkreter Werkzeuge für jede Etappe der Gästereise, von Fragen vor der Buchung bis zu Bewertungen nach der Abreise. Wir teilen sie in drei Gruppen: das, was sich bereits rechnet, das, was Vorbereitung erfordert, und das, was vorerst vor allem ein Versprechen ist.
KI im Finanzwesen trifft immer häufiger die erste Entscheidung anstelle eines Menschen – bei der Bonitätsprüfung, der Betrugserkennung oder der Qualifizierung von Anträgen. Wir erklären, wie solche Systeme funktionieren, welche Daten sie nutzen und wo die realen Schwierigkeiten der Implementierung liegen.